A revisão de código com IA pega bem erro de lógica, efeito colateral em outra parte do sistema e falha de segurança evidente, e não pega regra de negócio que ninguém escreveu, decisão de arquitetura nem o que só o time sabe sobre a produção. Em 26 pull requests dos nossos projetos, entre agosto e setembro de 2026, ela apontou 51 problemas antes do merge, e o maior grupo foi de resultado errado em tela e relatório. Ela só funciona quando revisa contra o padrão escrito da casa, e quem aprova o merge é sempre uma pessoa do time.
O que é a revisão de código com IA num pull request#
A revisão de código com IA é um modelo de linguagem lendo uma mudança no sistema antes de ela entrar no código principal e deixando comentários sobre o que pode dar errado. Ela vem antes da leitura de uma pessoa do time, para que essa pessoa gaste o tempo dela no que exige julgamento.
O pull request é o pedido que o desenvolvedor abre para juntar a mudança dele ao sistema. Antes de aceitar, alguém lê o que mudou, e essa leitura é o code review. Quando o volume de código cresce, a revisão vira o gargalo, e é aí que entra a IA.
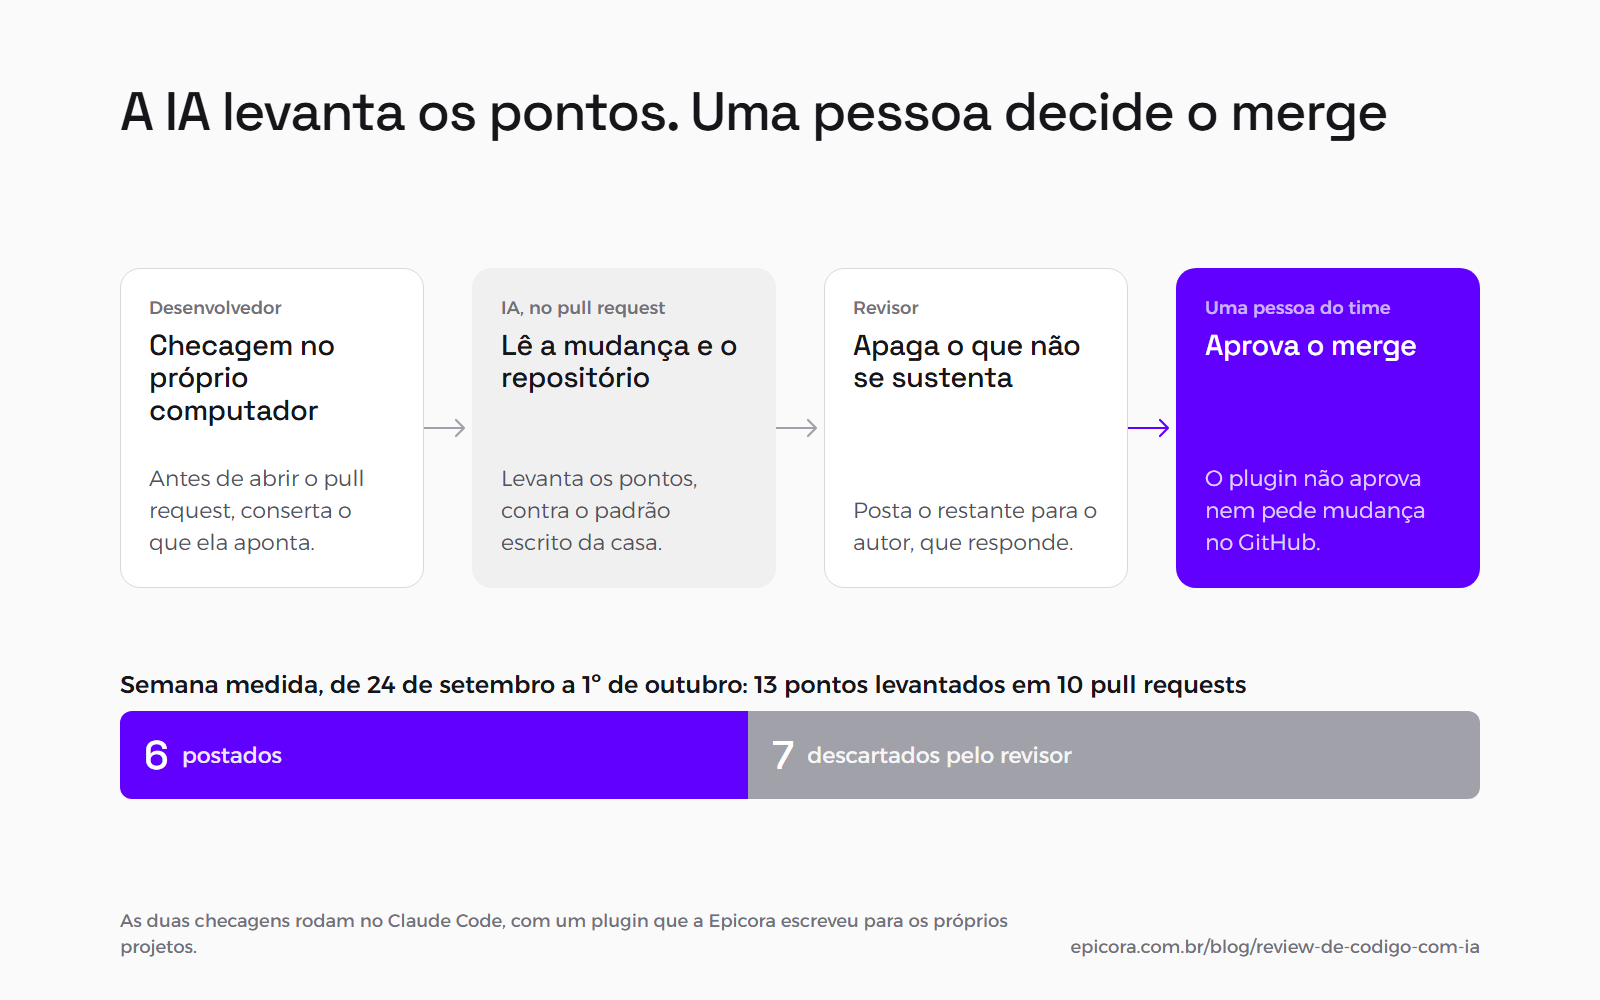
Na Epicora, ela aparece em dois momentos. O desenvolvedor roda uma checagem no próprio computador antes de abrir o pull request e conserta o que ela aponta. Depois, o revisor roda a revisão no pull request aberto, lê o que a IA levantou, apaga o que não se sustenta e posta o restante para o autor. As duas rodam no Claude Code, com um plugin que escrevemos para os nossos projetos, e nenhuma delas aprova nada no GitHub. É o mesmo desenho que usamos quando levamos IA para os processos de uma empresa: a IA faz a primeira passada, e a decisão fica com quem responde por ela.
O que a IA apontou em 26 pull requests reais#
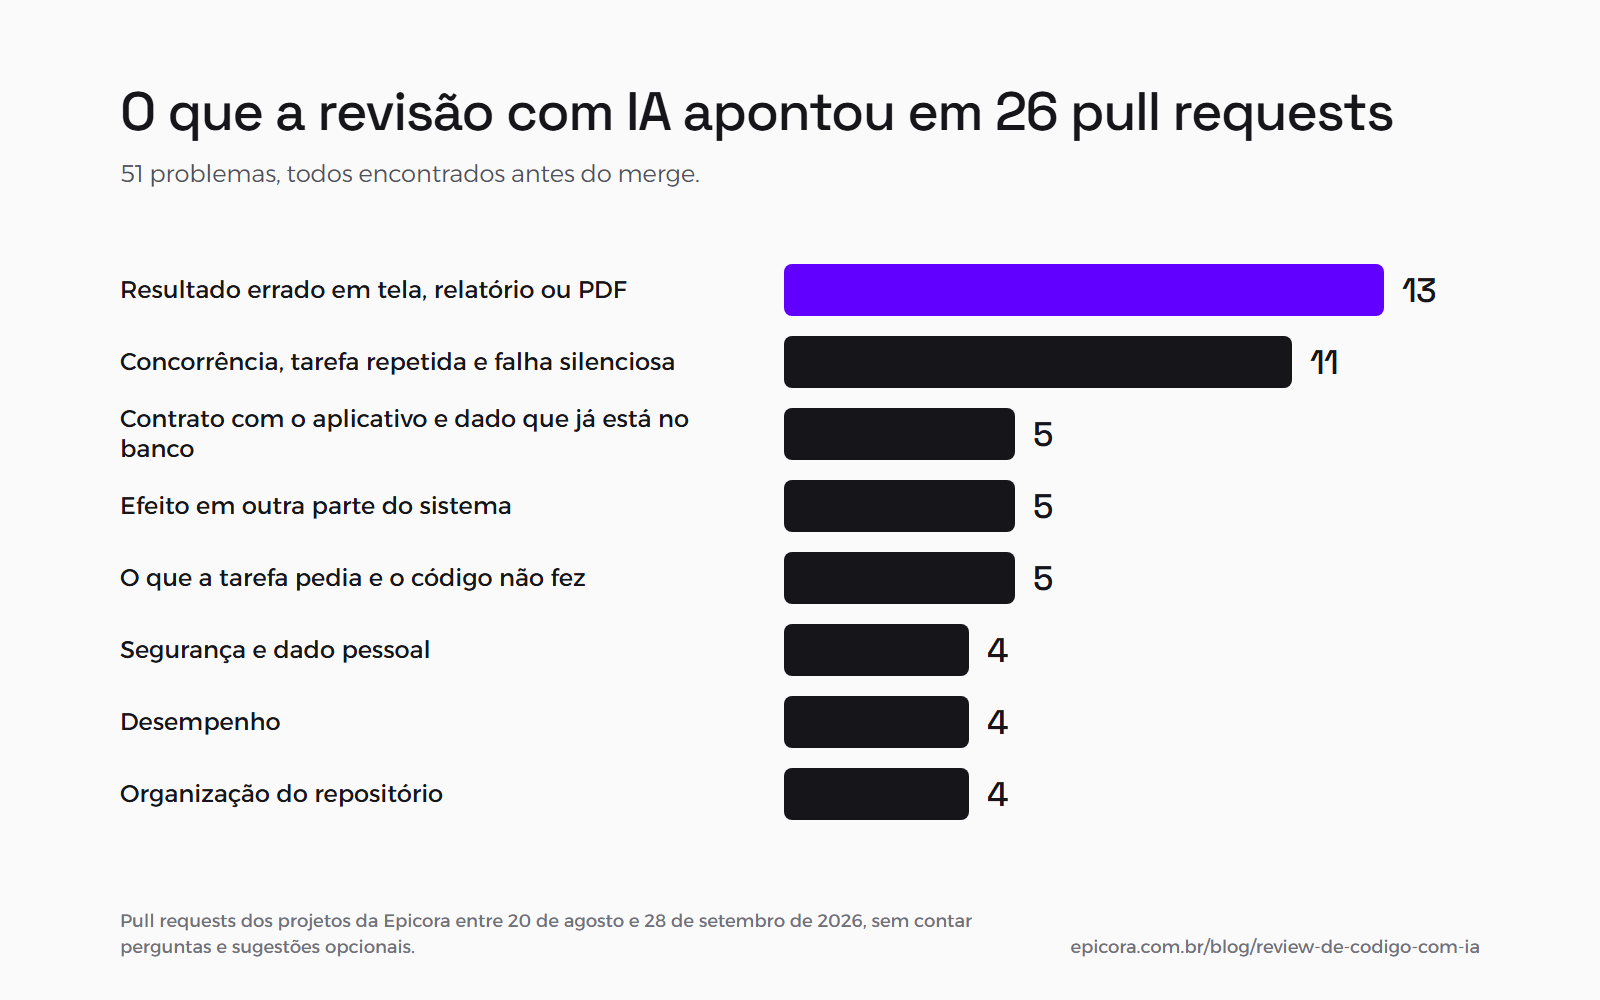
Entre 20 de agosto e 28 de setembro de 2026, separamos os 26 pull requests dos nossos projetos em que a revisão com IA foi postada como mensagem para o autor, a maior parte de backend. Lemos cada mensagem e contamos o que ela apontava. Foram 51 problemas, todos encontrados antes do merge, sem contar as perguntas e as sugestões opcionais.
| O que a revisão apontou | Pontos | Exemplo |
|---|---|---|
| Resultado errado em tela, relatório ou PDF | 13 | um indicador que contava duas vezes o mesmo item quando dois usuários usavam a mesma configuração |
| Concorrência, tarefa repetida e falha silenciosa | 11 | duas mensagens chegando ao mesmo tempo geravam dois avisos separados, justamente o que a mudança queria agrupar |
| Contrato com o aplicativo e dado que já está no banco | 5 | a sincronização deixava de mandar um dado que o aplicativo usava sem sinal |
| Efeito em outra parte do sistema | 5 | um conserto de fuso horário corrigia a tela do pull request e atrasava em um dia outra tela, fora do trecho alterado |
| O que a tarefa pedia e o código não fez | 5 | o campo preenchido no formulário não chegava ao registro final |
| Segurança e dado pessoal | 4 | permissão mais ampla do que a tarefa pedia |
| Desempenho | 4 | uma consulta sem índice que leria a coleção inteira a cada acesso |
| Organização do repositório | 4 | arquivos de outro gerenciador de pacotes que entraram sem necessidade |
| Total | 51 |
Além desses 51, as mensagens traziam 12 perguntas sobre a regra ou sobre a tarefa, 5 avisos do que precisava acontecer antes ou depois de publicar, como ajustar dados que já estavam gravados, e 8 sugestões menores, marcadas como opcionais.
O maior grupo é o de resultado errado: um número que conta em dobro, uma legenda de relatório que diz o contrário do valor ao lado, um campo que se perde no caminho até o PDF. É o tipo de erro que passa num teste rápido, porque a tela abre e mostra alguma coisa.
Cinco pontos estavam fora das linhas que o pull request alterou. A revisão só encontra esse tipo de problema porque lê o repositório e segue quem usa a função alterada, em vez de olhar só o trecho que mudou.
A contagem tem um viés que vale dizer. Pull request em que a revisão não encontrou nada costuma terminar numa aprovação simples, sem mensagem, e fica fora dessa conta. Os 51 pontos descrevem o que ela acha quando acha, e não a proporção de pull requests com problema.
O que a IA pega bem, o que pega mal e o que não pega#
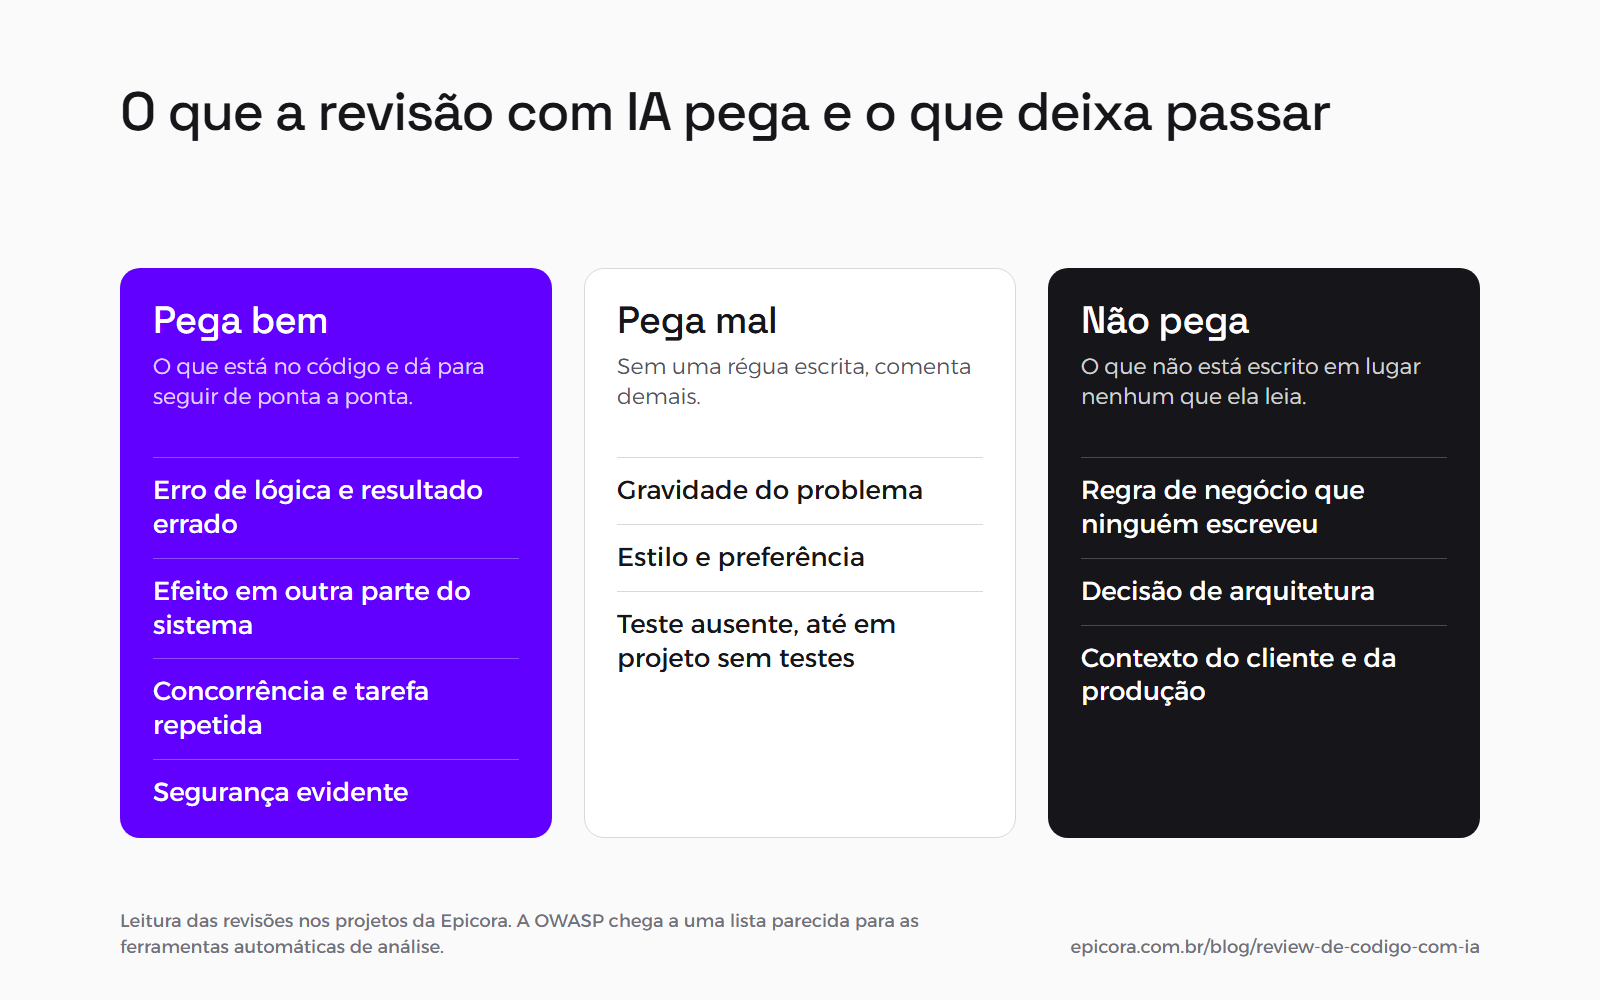
A IA pega bem o que está no código e pode ser seguido de ponta a ponta: lógica, efeito colateral, concorrência e segurança evidente. Pega mal a gravidade e o estilo, porque tende a comentar demais. E não pega o que não está escrito em lugar nenhum que ela leia.
| Tipo de problema | Como a IA se sai | Por quê |
|---|---|---|
| Erro de lógica e resultado errado | pega bem | ela segue o dado do banco até a tela e confere a conta |
| Efeito em outra parte do sistema | pega bem, se lê o repositório | precisa abrir quem usa a função alterada, e não só o diff |
| Concorrência e tarefa repetida | pega bem, se o padrão lista o sinal | o padrão da casa diz o que procurar, como repetição sem proteção |
| Segurança evidente | pega bem | rota sem verificação de permissão e dado pessoal exposto aparecem no próprio código |
| Critério de aceite da tarefa | pega, se a tarefa está escrita e ligada ao PR | sem a tarefa, ela não tem com o que comparar |
| Gravidade do problema | pega mal sem régua escrita | tende a marcar tudo como grave |
| Estilo e preferência | pega demais | vira ruído, e o formatador automático já resolve |
| Teste ausente | pega mal | cobra teste até em projeto que não tem testes |
| Regra de negócio que ninguém escreveu | não pega | vira pergunta para quem define a regra |
| Decisão de arquitetura | não pega | depende de custo, prazo e futuro do produto |
| Contexto do cliente e da produção | não pega | o que o time já testou e o estado dos dados não estão no código |
A folha de revisão de código seguro da OWASP, escrita pensando nas ferramentas automáticas de análise, chega a uma lista parecida. Ela aponta as falhas de lógica de negócio, que exigem conhecer o domínio, e as vulnerabilidades que dependem das regras da aplicação como o lugar em que a análise humana mais rende. E recomenda julgamento humano para filtrar o falso positivo das ferramentas.
Um exemplo do nosso próprio painel de gestão mostra a fronteira. A revisão percebeu que um colaborador recontratado aparecia com o tempo de casa contando o período em que esteve fora. Em vez de marcar como erro, ela escreveu que a dúvida era de regra, e não de código, e deixou a pergunta para quem define a regra. Contar ou não o vínculo anterior é uma decisão da empresa.
Por que a revisão por IA genérica vira ruído#
A revisão por IA vira ruído quando comenta tudo com o mesmo peso. O time aprende a ignorar os comentários, inclusive no dia em que um deles é sério. O que resolve é revisar contra um padrão escrito, com uma régua clara do que é grave.
Aprendemos isso com a primeira versão do nosso plugin. O registro de calibragem de 9 de setembro de 2026 descreve o sintoma: quase todo pull request revisado terminava em pedido de mudança. A gravidade vinha inflada, e o caso mais comum era cobrar teste em projeto sem suíte de testes. Nenhum ponto era verificado antes de ser escrito, então o falso positivo chegava ao autor com a mesma cara de defeito real. Na época, eram dois revisores para cinco a seis desenvolvedores, e a fila de revisão consumia manhãs inteiras.
A calibragem mudou três coisas.
- Uma régua escrita para o que bloqueia. Um ponto só segura o merge com três condições ao mesmo tempo: um caminho real que chega no erro, um dano de uma lista fechada (sistema quebrado, dado perdido, permissão, aplicativo publicado, migração destrutiva) e um conserto caro de desfazer.
- O que dá para medir sai das mãos do modelo. Um programa confere antes se o projeto tem testes e formatador automático. Sem suíte de testes, a IA não pode cobrar teste. Estilo nunca vira ponto.
- Uma segunda leitura tenta derrubar cada ponto. Antes do relatório, outra instância procura uma proteção que já exista, um fluxo que torne o comportamento intencional ou alguém que o conserto quebraria. Ponto derrubado sai do relatório.
Desde o fim de setembro, cada rodada da revisão deixa um registro no pull request, e isso permite medir o que a IA achou e o que o revisor aproveitou. Na primeira semana medida, de 24 de setembro a 1º de outubro, a revisão levantou 13 pontos em 10 pull requests. O revisor postou 6 e descartou 7, entre eles as 3 sugestões menores. Das 11 rodadas registradas, nenhuma recomendou pedido de mudança.
É a mesma lógica de fazer a IA seguir o método da sua empresa: o critério mora num documento que a IA lê na hora de trabalhar, e o que pode ser medido é medido por código.
Por que a IA não aprova o pull request#
A IA não aprova pull request porque o que decide o merge muitas vezes está fora do código. Nos nossos projetos, a revisão comenta e uma pessoa do time aprova. O plugin não aprova nem pede mudança no GitHub: essa ação é sempre do revisor.
O mercado está indo em outra direção. Segundo a documentação do GitHub, a aprovação do Copilot pode ser configurada para contar como a aprovação de um colega na regra de aprovação obrigatória do repositório, num recurso em prévia pública. A mesma página diz que o Copilot não garante encontrar todos os problemas, que às vezes erra, e recomenda completar a revisão dele com uma revisão humana.
Na nossa amostra, três respostas de autores mostram por quê. Numa revisão, a IA perguntou se a ordenação de um ranking era feita no servidor ou na tela, e o autor respondeu que a tela já ordenava. Em outra, ela avisou que uma regra nova de valor único ia falhar por causa de registros duplicados no banco, e as duplicatas já tinham sido limpas em homologação e produção. Numa terceira, ela apontou que a sincronização deixava de mandar dois campos para o aplicativo; o autor ajustou e confirmou que tinha testado o aplicativo sem sinal. Nos três casos, quem tinha a informação que decidia era o time.
O plugin também tem uma porta que deixa o pull request seguir para o QA sem esperar o revisor, quando a checagem do autor sai limpa e nenhum gatilho de risco fecha. Na semana medida, 21 pull requests passaram por essa checagem e nenhum saiu liberado sem revisor. Os gatilhos que mais seguraram foram o QA pendente e a conferência com a tarefa, presentes nos 21.
Por que o código escrito com IA pede mais revisão#
O código escrito com IA pede mais revisão porque ela ficou muito boa em escrever código que funciona e não melhorou na mesma medida em escrever código seguro. Segundo a atualização de março de 2026 do relatório de segurança de código da Veracode, que já avaliou mais de 150 modelos, só 55% das tarefas de geração resultam em código seguro, praticamente o mesmo índice de dois anos antes. No mesmo estudo, o código gerado compila em mais de 95% dos casos.
Na prática, isso quer dizer que o código passa no teste de "abre e funciona" e carrega o problema para a produção. No Sistema Forja, um produto construído inteiro pelos fundadores conversando com uma IA, o diagnóstico encontrou os oito endpoints de servidor aceitando requisição sem autenticação, inclusive os de pagamento. Ninguém tinha revisado o que foi para o ar.
Quando mais código é escrito por IA, a revisão passa a ser o lugar em que alguém confere quem pode chamar o quê e se o número está certo. Por isso ela precisa ser rápida e não pode afogar o time em comentário. O que fazer com um produto que já nasceu assim está em o que dá para salvar de um código gerado por IA.
O que perguntar a quem desenvolve o seu sistema#
Quem contrata desenvolvimento não precisa ler código para saber se a revisão existe. Basta pedir para ver três ou quatro pull requests recentes e fazer quatro perguntas.
- Todo pull request é lido por uma pessoa antes do merge? A aprovação tem que ter nome. Se a resposta é "a IA revisa", pergunte quem aprova.
- A revisão segue um padrão escrito do projeto? Pode ser um arquivo de convenções no repositório ou um documento interno. Sem um padrão, a IA revisa por critérios genéricos, que não são os do seu projeto.
- A tarefa fica ligada ao pull request? Com o critério de aceite escrito, a revisão confere se o código faz o que foi pedido. Na nossa amostra, 5 pontos eram exatamente isso.
- O que acontece com o comentário da IA? O comentário bom tem o arquivo, a linha, o que acontece e em que condição. O autor responde, e alguém decide.
Uma empresa que revisa de verdade responde às quatro mostrando pull requests reais. Quando ela não consegue mostrar, o próximo passo é uma auditoria do código antes de o produto crescer.
Perguntas frequentes#
A IA pode substituir o revisor de código?#
Não. Ela faz bem a primeira leitura: acha erro de lógica, efeito em outra parte do sistema e falha de segurança evidente, e faz isso em todo pull request, sem cansar. O que ela não tem é o contexto que decide o merge: a regra de negócio que não foi escrita, a decisão de arquitetura e o que o time sabe sobre a produção. Nos nossos projetos, a IA levanta os pontos, o revisor descarta o que não se sustenta e quem aprova é sempre uma pessoa.
Quanto do que a IA aponta numa revisão é útil?#
Depende de quanto ela foi calibrada. Na primeira versão da nossa revisão, quase todo pull request terminava em pedido de mudança, com gravidade inflada e cobrança de teste em projeto sem testes. Depois de escrever o padrão da casa e fazer a revisão obedecer a ele, a primeira semana medida teve 13 pontos levantados em 10 pull requests, e o revisor aproveitou 6.
A revisão com IA pega falha de segurança?#
Pega as evidentes: rota sem verificação de permissão, dado pessoal que passaria a aparecer para quem não devia, entrada pública sem validação. Nos nossos 26 pull requests, foram 4 pontos desse tipo, todos antes do merge. O que ela não decide sozinha é a permissão que depende da regra do negócio, como quem pode ver o quê em cada situação. Para isso, a regra precisa estar escrita e uma pessoa precisa conferir.
Basta ligar uma ferramenta pronta de revisão no GitHub?#
Ligar é fácil, e a ferramenta vai comentar. O que define se o comentário ajuda é o padrão que ela lê. A própria documentação do GitHub orienta a ensinar o padrão do projeto por arquivos de instrução no repositório, como o copilot-instructions.md e o AGENTS.md. Sem um padrão escrito e sem uma régua do que é grave, a revisão comenta demais e o time para de ler.
Como sei se a empresa que desenvolve o meu sistema revisa o código?#
Peça para ver alguns pull requests recentes. Um processo saudável mostra a tarefa ligada ao pull request, comentários de revisão com o arquivo e a linha do problema, a resposta de quem escreveu o código e a aprovação de uma pessoa antes do merge. Se a revisão é feita por IA, pergunte qual padrão ela segue e quem decide o que vai para o ar.
Fontes#
- Veracode, Spring 2026 GenAI Code Security Update, 24 de março de 2026: https://www.veracode.com/blog/spring-2026-genai-code-security/
- GitHub Docs, sobre a revisão de código do Copilot: https://docs.github.com/en/copilot/concepts/agents/code-review
- OWASP Cheat Sheet Series, Secure Code Review Cheat Sheet: https://cheatsheetseries.owasp.org/cheatsheets/Secure_Code_Review_Cheat_Sheet.html
- Dado próprio: mensagens de revisão postadas em 26 pull requests dos projetos da Epicora entre 20 de agosto e 28 de setembro de 2026, e o relatório de métricas do plugin de revisão da semana de 24 de setembro a 1º de outubro de 2026.
Próximo passo#
Se o seu sistema foi construído com IA e ninguém revisou o que foi para o ar, comece pelo diagnóstico de código feito com IA, que olha código, banco e infraestrutura e corrige o que é crítico. Se o seu time já desenvolve e quer revisão com IA seguindo um padrão escrito da casa, isso é parte do nosso trabalho em IA e automação.