La revisión de código con IA detecta bien errores de lógica, efectos colaterales en otra parte del sistema y fallas de seguridad evidentes, y no detecta reglas de negocio que nadie escribió, decisiones de arquitectura ni lo que solo el equipo sabe sobre producción. En 26 pull requests de nuestros proyectos, entre agosto y septiembre de 2026, señaló 51 problemas antes del merge, y el grupo más grande fue el de resultados incorrectos en pantallas e informes. Solo funciona cuando revisa contra el estándar escrito de la casa, y quien aprueba el merge es siempre una persona del equipo.
Qué es la revisión de código con IA en un pull request#
La revisión de código con IA es un modelo de lenguaje que lee un cambio en el sistema antes de que entre al código principal y deja comentarios sobre lo que puede salir mal. Viene antes de la lectura de una persona del equipo, para que esa persona dedique su tiempo a lo que requiere criterio.
El pull request es la solicitud que abre el desarrollador para incorporar su cambio al sistema. Antes de aceptarlo, alguien lee lo que cambió, y esa lectura es la revisión de código, el code review. Cuando el volumen de código crece, la revisión se vuelve el cuello de botella, y ahí entra la IA.
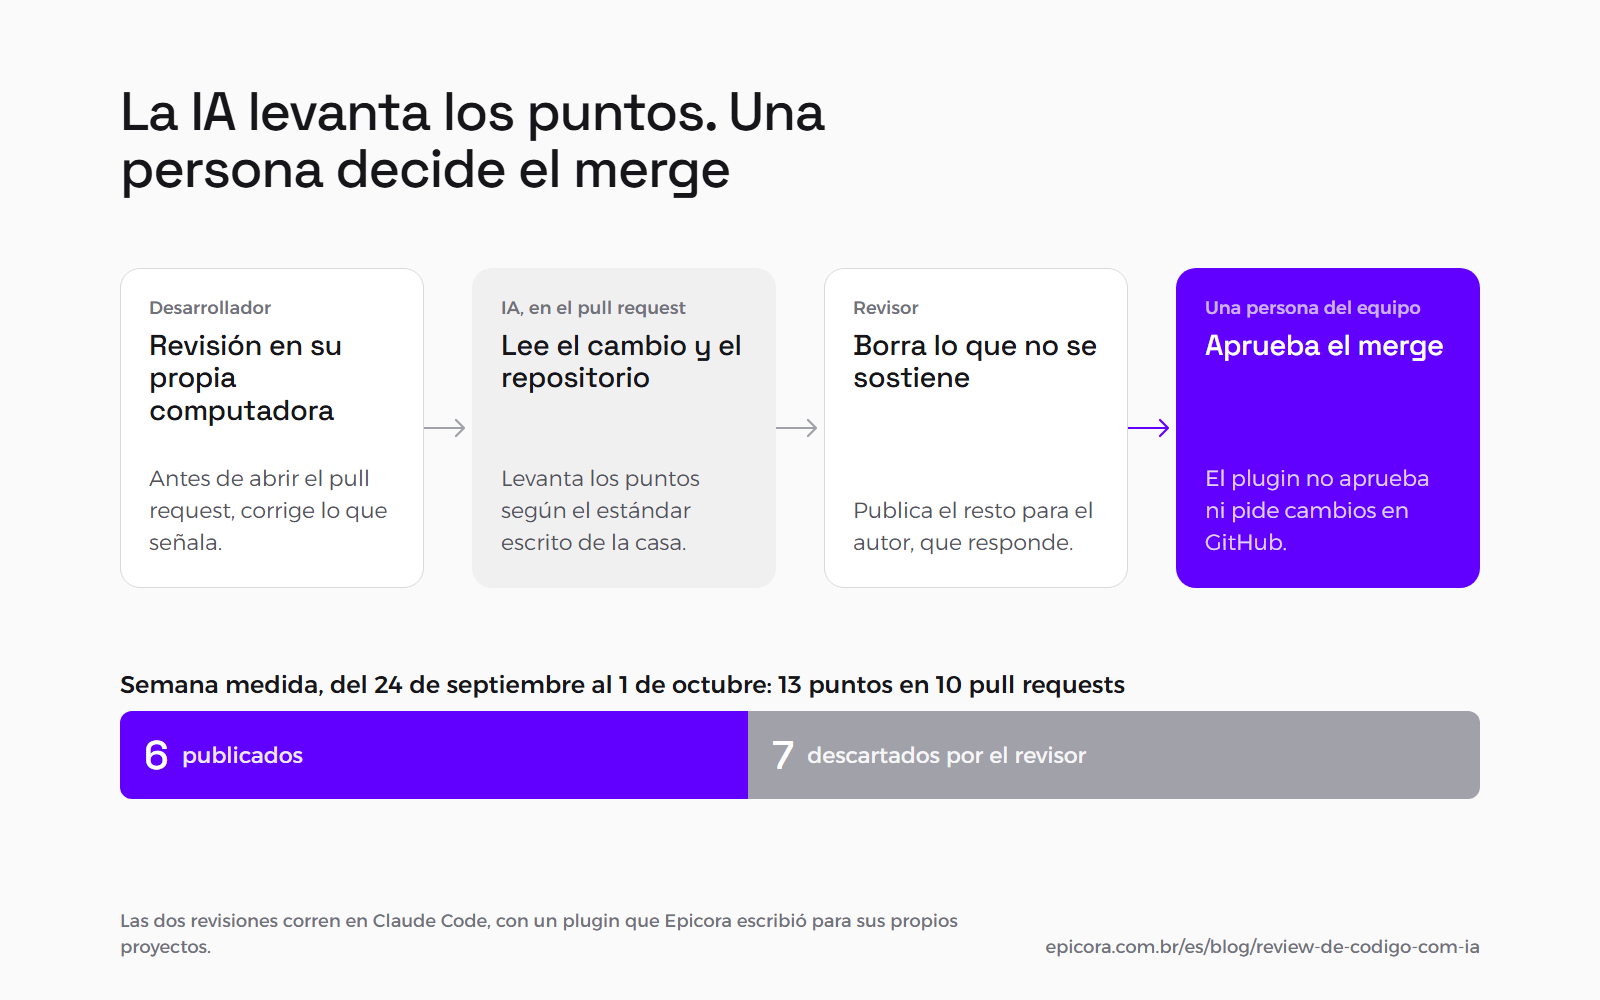
En Epicora aparece en dos momentos. El desarrollador corre una verificación en su propia computadora antes de abrir el pull request y corrige lo que señala. Después, el revisor corre la revisión sobre el pull request abierto, lee lo que levantó la IA, borra lo que no se sostiene y publica el resto para el autor. Las dos corren en Claude Code, con un plugin que escribimos para nuestros proyectos, y ninguna aprueba nada en GitHub. Es el mismo diseño que usamos cuando llevamos IA a los procesos de una empresa: la IA hace la primera pasada y la decisión queda con quien responde por ella.
Qué señaló la IA en 26 pull requests reales#
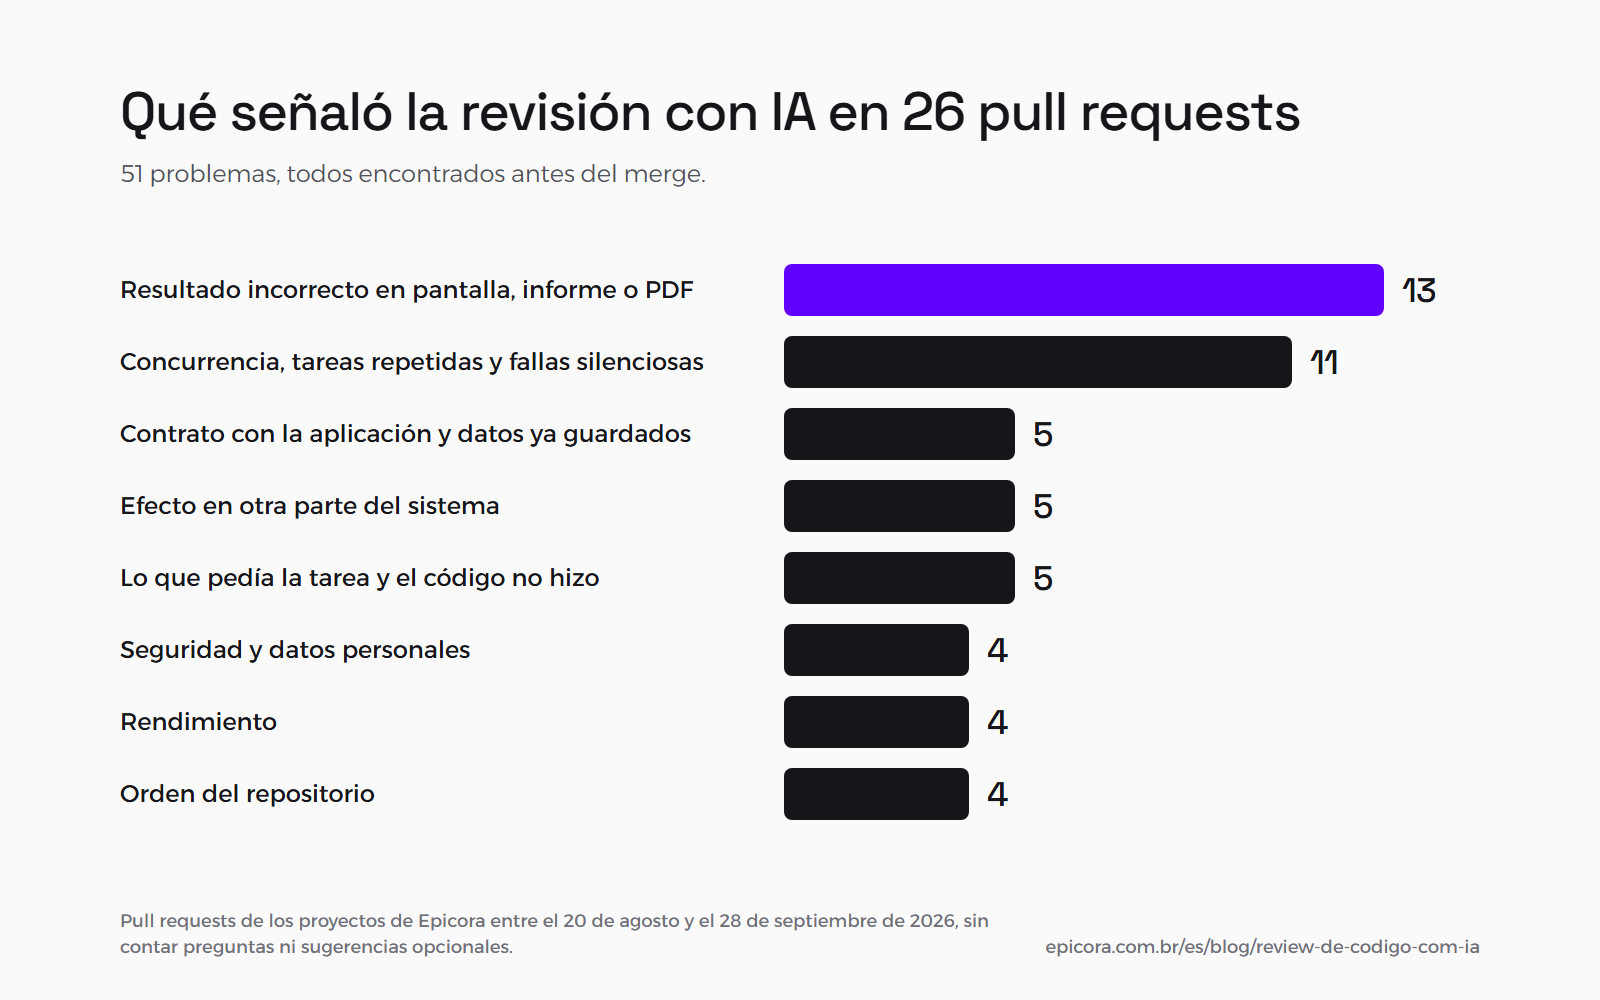
Entre el 20 de agosto y el 28 de septiembre de 2026 separamos los 26 pull requests de nuestros proyectos en los que la revisión con IA se publicó como mensaje para el autor, la mayoría de backend. Leímos cada mensaje y contamos lo que señalaba. Fueron 51 problemas, todos encontrados antes del merge (la incorporación del cambio), sin contar las preguntas ni las sugerencias opcionales.
| Qué señaló la revisión | Puntos | Ejemplo |
|---|---|---|
| Resultado incorrecto en pantalla, informe o PDF | 13 | un indicador que contaba dos veces el mismo elemento cuando dos usuarios compartían la misma configuración |
| Concurrencia, tareas repetidas y fallas silenciosas | 11 | dos mensajes que llegaban al mismo tiempo generaban dos notificaciones separadas, justo lo que el cambio quería agrupar |
| Contrato con la aplicación y datos que ya están en la base | 5 | la sincronización dejaba de enviar un dato que la aplicación usaba sin conexión |
| Efecto en otra parte del sistema | 5 | una corrección de zona horaria arreglaba la pantalla del pull request y atrasaba un día otra pantalla, fuera de las líneas modificadas |
| Lo que pedía la tarea y el código no hizo | 5 | el campo llenado en el formulario no llegaba al registro final |
| Seguridad y datos personales | 4 | un permiso más amplio de lo que pedía la tarea |
| Rendimiento | 4 | una consulta sin índice que leería la colección entera en cada acceso |
| Orden del repositorio | 4 | archivos de otro gestor de paquetes que entraron sin necesidad |
| Total | 51 |
Además de esos 51, los mensajes traían 12 preguntas sobre la regla o sobre la tarea, 5 avisos de lo que tenía que pasar antes o después de publicar, como ajustar datos ya guardados, y 8 sugerencias menores, marcadas como opcionales.
El grupo más grande es el de resultados incorrectos: un número que cuenta doble, una leyenda de informe que dice lo contrario del valor de al lado, un campo que se pierde en el camino hasta el PDF. Es el tipo de error que pasa una prueba rápida, porque la pantalla abre y muestra algo.
Cinco puntos estaban fuera de las líneas que el pull request modificó. La revisión solo encuentra este tipo de problema porque lee el repositorio y sigue a quien usa la función modificada, en vez de mirar solo el fragmento que cambió.
El conteo tiene un sesgo que conviene decir. Un pull request en el que la revisión no encontró nada suele terminar en una aprobación simple, sin mensaje, y queda fuera de esta cuenta. Los 51 puntos describen lo que encuentra cuando encuentra algo, y no la proporción de pull requests con problemas.
Qué detecta bien la IA, qué detecta mal y qué no detecta#
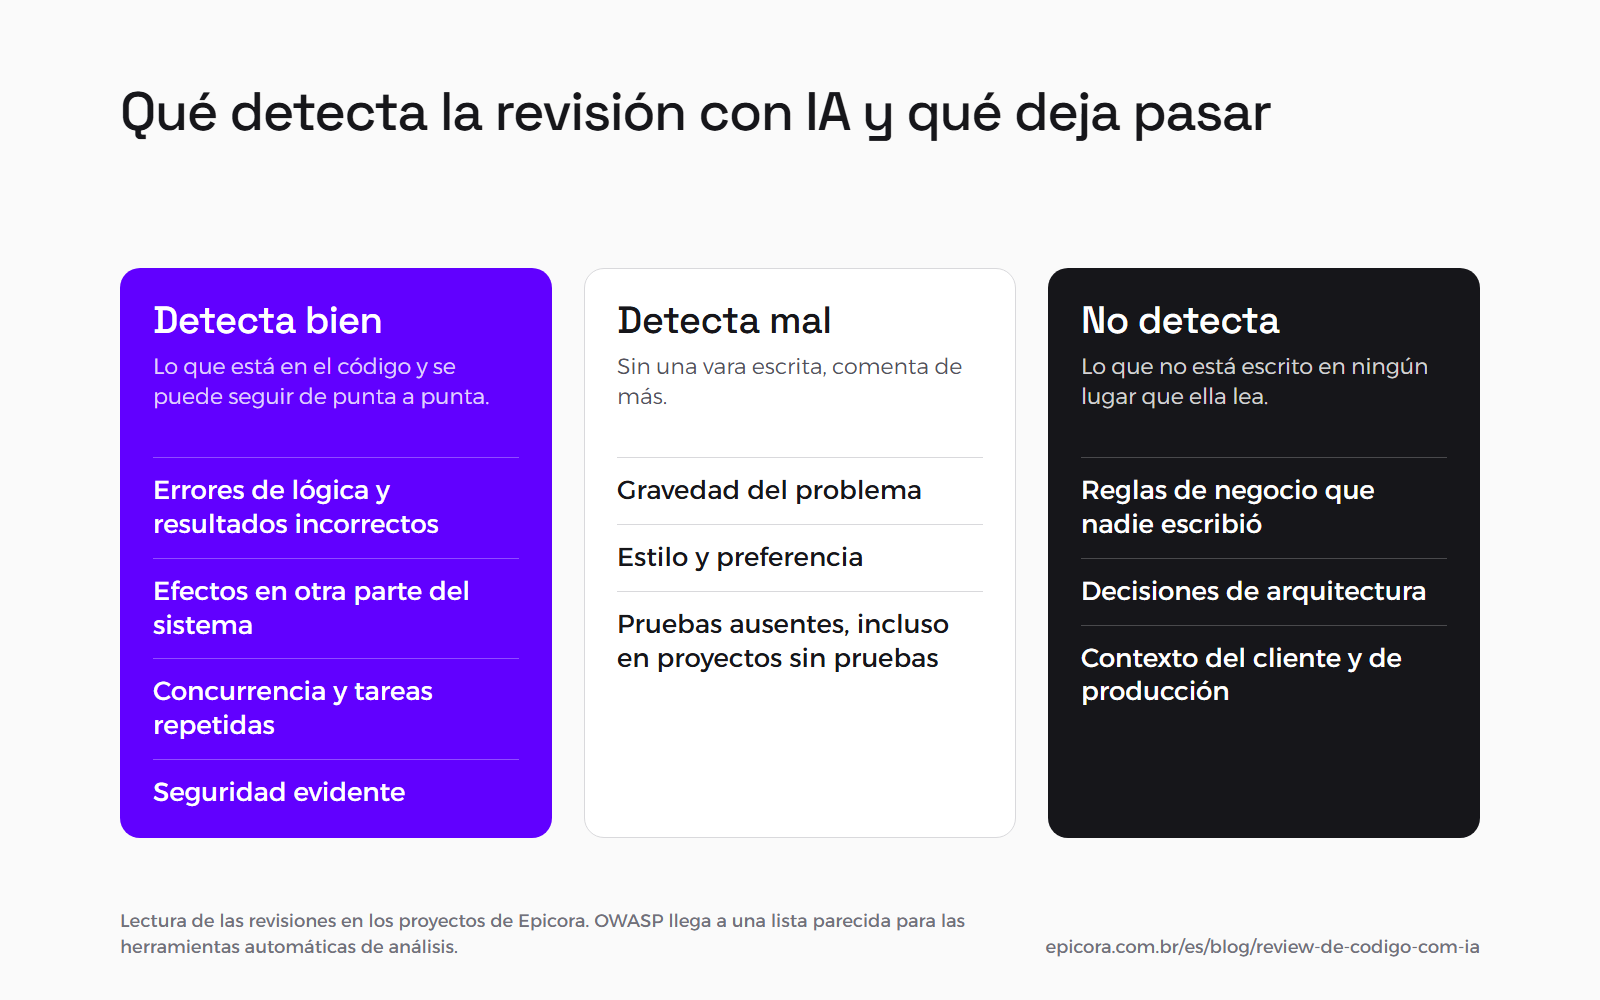
La IA detecta bien lo que está en el código y se puede seguir de punta a punta: lógica, efectos colaterales, concurrencia y seguridad evidente. Maneja mal la gravedad y el estilo, porque tiende a comentar de más. Y no detecta lo que no está escrito en ningún lugar que ella lea.
| Tipo de problema | Cómo le va a la IA | Por qué |
|---|---|---|
| Error de lógica y resultado incorrecto | lo detecta bien | sigue el dato desde la base hasta la pantalla y verifica la cuenta |
| Efecto en otra parte del sistema | lo detecta bien, si lee el repositorio | tiene que abrir a quien usa la función modificada, no solo el diff |
| Concurrencia y tareas repetidas | lo detecta bien, si el estándar lista la señal | el estándar de la casa dice qué buscar, como reintentos sin protección |
| Seguridad evidente | lo detecta bien | una ruta sin verificación de permisos o un dato personal expuesto aparecen en el propio código |
| Criterio de aceptación de la tarea | lo detecta, si la tarea está escrita y vinculada al PR | sin la tarea, no tiene con qué comparar |
| Gravedad del problema | lo hace mal sin una vara escrita | tiende a marcar todo como grave |
| Estilo y preferencia | comenta de más | se vuelve ruido, y el formateador automático ya lo resuelve |
| Pruebas ausentes | lo hace mal | pide pruebas incluso en proyectos sin pruebas automatizadas |
| Regla de negocio que nadie escribió | no lo detecta | se vuelve una pregunta para quien define la regla |
| Decisión de arquitectura | no lo detecta | depende de costo, plazo y futuro del producto |
| Contexto del cliente y de producción | no lo detecta | lo que el equipo ya probó y el estado de los datos no están en el código |
La hoja de revisión de código seguro de OWASP, escrita pensando en las herramientas automáticas de análisis, llega a una lista parecida. Señala las fallas de lógica de negocio, que exigen conocer el dominio, y las vulnerabilidades que dependen de las reglas propias de la aplicación como los puntos donde el análisis humano más aporta. Y recomienda criterio humano para filtrar los falsos positivos de las herramientas.
Un ejemplo de nuestro propio panel de gestión interno muestra el límite. La revisión notó que un colaborador recontratado aparecía con una antigüedad que incluía el tiempo en que estuvo fuera. En vez de marcarlo como error, escribió que la duda era de regla y no de código, y dejó la pregunta para quien define la regla. Contar o no el vínculo anterior es una decisión de la empresa.
Por qué la revisión con IA genérica se vuelve ruido#
La revisión con IA se vuelve ruido cuando comenta todo con el mismo peso. El equipo aprende a ignorar los comentarios, incluso el día en que uno de ellos es serio. Lo que lo resuelve es revisar contra un estándar escrito, con una vara clara de qué es grave.
Lo aprendimos con la primera versión de nuestro plugin. El registro de calibración del 9 de septiembre de 2026 describe el síntoma: casi todo pull request revisado terminaba en pedido de cambios. La gravedad venía inflada, y el caso más común era pedir pruebas en proyectos sin pruebas automatizadas. Ningún punto se verificaba antes de escribirse, así que el falso positivo llegaba al autor con la misma cara de un defecto real. En ese momento éramos dos revisores para cinco o seis desarrolladores, y la fila de revisión se comía mañanas enteras.
La calibración cambió tres cosas.
- Una vara escrita para lo que bloquea. Un punto solo frena el merge con tres condiciones a la vez: un camino real que llega al error, un daño de una lista cerrada (sistema caído, datos perdidos, permisos, aplicación publicada, migración destructiva) y una corrección cara de deshacer.
- Lo que se puede medir sale de las manos del modelo. Un programa verifica antes si el proyecto tiene pruebas y formateador automático. Sin pruebas automatizadas, la IA no puede pedirlas. El estilo nunca se vuelve un punto.
- Una segunda lectura intenta derribar cada punto. Antes del informe, otra instancia busca una protección que ya exista, un flujo que vuelva intencional el comportamiento o a alguien que la corrección rompería. El punto derribado sale del informe.
Desde fines de septiembre, cada pasada de la revisión deja un registro en el pull request, y eso permite medir lo que la IA encontró y lo que el revisor aprovechó. En la primera semana medida, del 24 de septiembre al 1 de octubre, la revisión levantó 13 puntos en 10 pull requests. El revisor publicó 6 y descartó 7, entre ellos las 3 sugerencias menores. De las 11 pasadas registradas, ninguna recomendó pedir cambios.
Es la misma lógica de hacer que la IA siga el método de su empresa: el criterio vive en un documento que la IA lee al momento de trabajar, y lo que se puede medir se mide con código.
Por qué la IA no aprueba el pull request#
La IA no aprueba pull requests porque lo que decide el merge muchas veces está fuera del código. En nuestros proyectos, la revisión comenta y una persona del equipo aprueba. El plugin no aprueba ni pide cambios en GitHub: esa acción es siempre del revisor.
El mercado va en otra dirección. Según la documentación de GitHub, la aprobación de Copilot se puede configurar para que cuente como la de un compañero en la regla de aprobación obligatoria del repositorio, en una función que está en vista previa pública. La misma página dice que Copilot no garantiza encontrar todos los problemas, que a veces se equivoca, y recomienda complementar su revisión con una revisión humana.
En nuestra muestra, tres respuestas de autores muestran por qué. En una revisión, la IA preguntó si el orden de un ranking se hacía en el servidor o en la pantalla, y el autor respondió que la pantalla ya lo ordenaba. En otra, avisó que una regla nueva de valor único iba a fallar por registros duplicados en la base, y los duplicados ya se habían limpiado en homologación y en producción. En una tercera, señaló que la sincronización dejaba de enviar dos campos a la aplicación; el autor lo ajustó y confirmó que había probado la aplicación sin conexión. En los tres casos, quien tenía la información que decidía era el equipo.
El plugin también tiene una compuerta que deja pasar el pull request a QA sin esperar al revisor, cuando la verificación del autor sale limpia y ningún disparador de riesgo se cierra. En la semana medida, 21 pull requests pasaron por esa verificación y ninguno salió liberado sin revisor. Los disparadores que más los frenaron fueron el QA pendiente y la comparación con la tarea, presentes en los 21.
Por qué el código escrito con IA necesita más revisión#
El código escrito con IA necesita más revisión porque la IA se volvió muy buena escribiendo código que funciona y no mejoró al mismo ritmo escribiendo código seguro. Según la actualización de marzo de 2026 del informe de seguridad de código de Veracode, que ya evaluó más de 150 modelos, solo el 55% de las tareas de generación resultan en código seguro, prácticamente el mismo índice de dos años antes. En el mismo estudio, el código generado compila en más del 95% de los casos.
En la práctica, el código pasa la prueba de "abre y funciona" y lleva el problema a producción. En el Sistema Forja, un producto construido por completo por sus fundadores conversando con una IA, el diagnóstico encontró los ocho endpoints de servidor aceptando solicitudes sin autenticación, incluidos los de pago. Nadie había revisado lo que salió a producción.
Cuanto más código escribe la IA, más la revisión se vuelve el lugar donde alguien verifica quién puede llamar a qué y si el número es correcto. Por eso tiene que ser rápida y no puede ahogar al equipo en comentarios. Qué hacer con un producto que ya nació así está en qué se puede salvar de un código generado por IA.
Qué preguntarle a quien desarrolla su sistema#
Quien contrata desarrollo no necesita leer código para saber si existe revisión. Basta con pedir ver tres o cuatro pull requests recientes y hacer cuatro preguntas.
- ¿Cada pull request lo lee una persona antes del merge? La aprobación tiene que tener nombre. Si la respuesta es "lo revisa la IA", pregunte quién aprueba.
- ¿La revisión sigue un estándar escrito del proyecto? Puede ser un archivo de convenciones en el repositorio o un documento interno. Sin un estándar, la IA revisa con criterios genéricos, que no son los de su proyecto.
- ¿La tarea queda vinculada al pull request? Con el criterio de aceptación escrito, la revisión verifica si el código hace lo que se pidió. En nuestra muestra, 5 puntos eran exactamente eso.
- ¿Qué pasa con el comentario de la IA? Un buen comentario tiene el archivo, la línea, lo que pasa y en qué condición. El autor responde, y alguien decide.
Una empresa que revisa de verdad responde las cuatro mostrando pull requests reales. Cuando no puede mostrarlos, el siguiente paso es una auditoría del código antes de que el producto crezca.
Preguntas frecuentes#
¿La IA puede reemplazar al revisor de código?#
No. Hace bien la primera lectura: encuentra errores de lógica, efectos en otra parte del sistema y fallas de seguridad evidentes, y lo hace en cada pull request sin cansarse. Lo que no tiene es el contexto que decide el merge: la regla de negocio que nadie escribió, la decisión de arquitectura y lo que el equipo sabe sobre producción. En nuestros proyectos, la IA levanta los puntos, el revisor descarta lo que no se sostiene y quien aprueba es siempre una persona.
¿Cuánto de lo que señala la IA en una revisión es útil?#
Depende de cuánto se la haya calibrado. En la primera versión de nuestra revisión, casi todo pull request terminaba en pedido de cambios, con la gravedad inflada y pidiendo pruebas en proyectos sin pruebas automatizadas. Después de escribir el estándar de la casa y hacer que la revisión lo siga, la primera semana medida tuvo 13 puntos en 10 pull requests, y el revisor aprovechó 6.
¿La revisión con IA detecta fallas de seguridad?#
Detecta las evidentes: una ruta sin verificación de permisos, un dato personal que empezaría a verse por quien no debe, una entrada pública sin validación. En nuestros 26 pull requests hubo 4 puntos de este tipo, todos antes del merge. Lo que no resuelve sola es el permiso que depende de la regla del negocio, como quién puede ver qué en cada situación. Para eso, la regla tiene que estar escrita y una persona tiene que revisarla.
¿Alcanza con activar una herramienta de revisión lista en GitHub?#
Activarla es fácil, y la herramienta va a comentar. Lo que define si el comentario sirve es el estándar que lee. La propia documentación de GitHub indica que el estándar del proyecto se enseña con archivos de instrucciones en el repositorio, como copilot-instructions.md y AGENTS.md. Sin un estándar escrito y sin una vara clara de qué es grave, la revisión comenta de más y el equipo deja de leer.
¿Cómo sé si la empresa que desarrolla mi sistema revisa el código?#
Pida ver algunos pull requests recientes. Un proceso sano muestra la tarea vinculada al pull request, comentarios de revisión con el archivo y la línea del problema, la respuesta de quien escribió el código y la aprobación de una persona antes del merge. Si la revisión la hace una IA, pregunte qué estándar sigue y quién decide lo que sale a producción.
Fuentes#
- Veracode, Spring 2026 GenAI Code Security Update, 24 de marzo de 2026: https://www.veracode.com/blog/spring-2026-genai-code-security/
- GitHub Docs, sobre la revisión de código de Copilot: https://docs.github.com/en/copilot/concepts/agents/code-review
- OWASP Cheat Sheet Series, Secure Code Review Cheat Sheet: https://cheatsheetseries.owasp.org/cheatsheets/Secure_Code_Review_Cheat_Sheet.html
- Datos propios: mensajes de revisión publicados en 26 pull requests de proyectos de Epicora entre el 20 de agosto y el 28 de septiembre de 2026, y el informe de métricas del plugin de revisión de la semana del 24 de septiembre al 1 de octubre de 2026.
Siguiente paso#
Si su sistema se construyó con IA y nadie revisó lo que salió a producción, empiece por el diagnóstico de código hecho con IA, que revisa el código, la base de datos y la infraestructura y corrige lo crítico. Si su equipo ya desarrolla y quiere una revisión con IA que siga un estándar escrito de la casa, eso es parte de nuestro trabajo en IA y automatización.