Offline-first não é uma funcionalidade do aplicativo: é uma decisão que muda o banco, o servidor e o escopo do produto — principalmente o que não vai para o aparelho. E um app que promete offline e trava é pior que um app online honesto: a diferença entre os dois está em detalhes que quase nunca aparecem na proposta. Quase toda escrita que o servidor recusa depois é uma regra que o app não conhecia, e a primeira correção é levar essa regra para dentro do aplicativo.
O que é offline-first, e por que não é cache#
Offline-first é a forma de construir um aplicativo em que ele lê e grava primeiro num banco de dados no próprio aparelho e sincroniza com o servidor quando há rede. A falta de sinal deixa de interromper o trabalho: a tela continua respondendo, e o que o usuário cria fica guardado no celular até subir. Cache é outra coisa: guarda respostas já recebidas, acelera leitura e não resolve escrita.
Cache guarda a resposta de uma requisição que já aconteceu, para não repeti-la. Serve para acelerar leitura e some quando o assunto é escrita: o que o usuário cria sem sinal não tem onde morar.
Offline-first é outra coisa. O aplicativo tem um banco de dados próprio no aparelho, e é dele que a tela lê — lista, busca, mapa, formulário. O servidor entra depois, em segundo plano. A rede deixa de ser condição para o trabalho acontecer.
O teste leva dez segundos: em modo avião, tente criar alguma coisa. Um app com cache falha ao gravar; um app offline-first cadastra, e o registro continua lá depois de fechar e reabrir.
A formulação mais conhecida dessa ideia é o ensaio "Local-first software: you own your data, in spite of the cloud", publicado pelo laboratório Ink & Switch em 2019, com Martin Kleppmann entre os autores. Dos sete ideais que ele lista, o mais relevante para software corporativo é o mais simples: a operação responde sem depender de ida e volta à rede.
Quando offline-first vale — e quando é dinheiro jogado fora#
Offline-first vale quando o trabalho acontece onde o sinal não é garantido: vendedor externo, checklist em obra, academia no subsolo. Não vale para quem usa o sistema sentado, com Wi-Fi — ali é complexidade permanente em troca de um problema que a pessoa não tem. A segunda pergunta é o que precisa funcionar sem rede: consultar é um problema, registrar é outro, bem maior.
O critério não é o setor da empresa. É onde o trabalho acontece.
Vendedor externo que atende o interior de três estados trabalha onde o sinal é hipótese, não fato. Operador que faz checklist de equipamento em obra, idem. Aluno que registra treino na academia costuma estar no subsolo. Nesses casos, o momento em que o sistema é usado é justamente o momento em que a rede não está. E vale o contrário: se a pessoa usa o sistema sentada, com Wi-Fi, offline-first é complexidade permanente em troca de um problema que ela não tem.
A segunda pergunta, quando a primeira dá "sim", é o que precisa funcionar sem rede. Só consultar é um problema; registrar é outro, bem maior, porque exige uma fila de saída e tudo que vem com ela.
| Decisão | O que ela impõe | Quando vale |
|---|---|---|
| Banco local no aparelho | espaço e memória no dispositivo; recorte explícito de quais dados descem | o trabalho acontece longe de rede confiável |
| Fila de escrita (envio posterior) | ordem entre registros, repetição em caso de falha e política para escrita recusada | a pessoa registra em campo, não só consulta |
| Identificador gerado no aparelho | o servidor deixa de ser quem batiza o registro | qualquer criação offline |
| Sincronização visível na interface | telas e textos que a maioria dos apps não tem | sempre — é o que evita o usuário achar que travou |
Nenhuma dessas linhas é opcional depois que a primeira é escolhida. É por isso que offline-first é decisão de escopo, e não ajuste fino no fim do projeto.
Por que um app offline ruim é pior que um app online honesto#
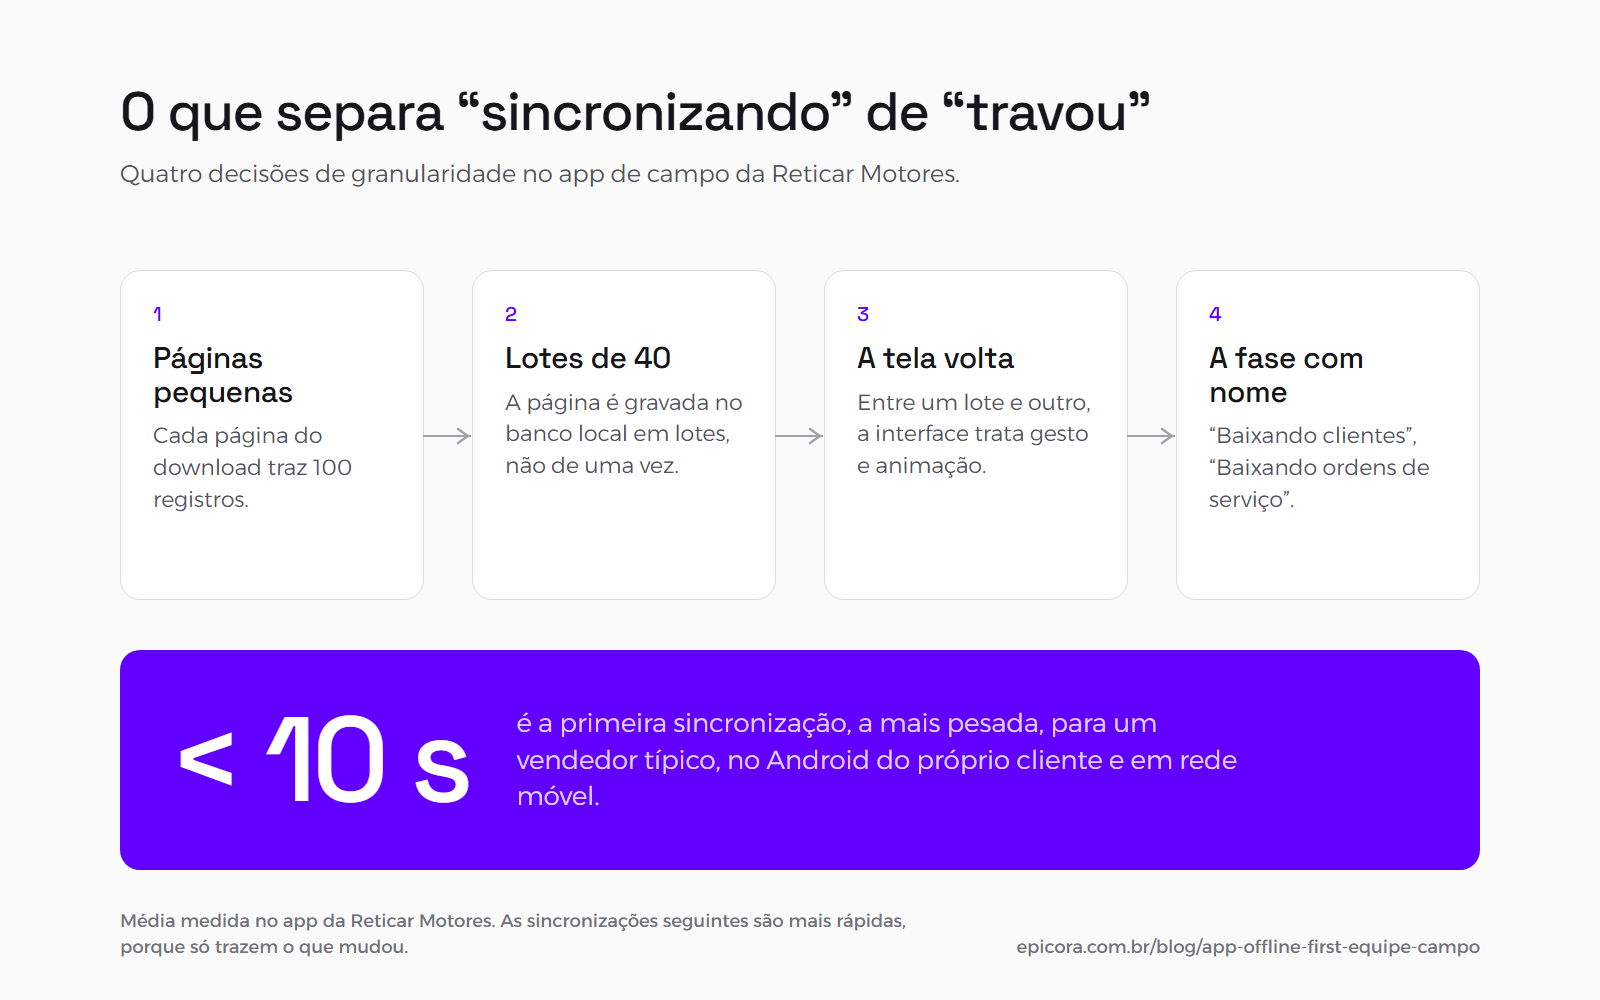
Um aplicativo offline mal feito gera mais retrabalho que um aplicativo honestamente online, porque a equipe deixa de confiar nele e volta a anotar no papel. A diferença não é conceitual, é de granularidade: baixar em páginas pequenas, gravar em lotes, devolver a tela ao usuário entre os lotes e mostrar a fase da sincronização com nome.
O sistema que a Reticar Motores usava antes do nosso já tinha comportamento offline — e era exatamente ele a origem da dor: a sincronização disparava a cada abertura e bloqueava o aplicativo inteiro enquanto rodava, piorava em conexão lenta ou instável, e o usuário não tinha como saber o que estava acontecendo nem se o que registrou havia subido.
O efeito numa equipe é previsível e caro: a pessoa deixa de confiar no aplicativo e volta a anotar no papel para digitar depois. Um app honestamente online, que diz "sem internet" e não finge, gera menos retrabalho que um app que promete autonomia e entrega congelamento.
A diferença entre os dois não é conceitual — é de granularidade, e são quatro decisões de implementação:
- Baixar em páginas pequenas. No app da Reticar, cada página do download traz 100 registros. Nosso projeto base usa páginas muito maiores, e para uma base grande isso significa segurar a interface por tempo demais.
- Aplicar em lotes. Quando a página é grande, os registros são gravados no banco local em lotes de 40, e não de uma vez.
- Devolver a tela ao usuário entre os lotes. Entre um lote e outro, o aplicativo entrega o processamento de volta para a interface tratar gesto e animação. É essa linha que separa "sincronizando em segundo plano" de "travou".
- Mostrar o que está acontecendo, com nome. A tela de sincronização diz a fase (enviando ou baixando) e a coleção em português — "Baixando clientes", "Baixando ordens de serviço". Quem espera sabendo o que espera não acha que o app morreu.
O resultado dessa soma, na Reticar: a primeira sincronização — a mais pesada, porque traz a carga inicial inteira — leva, em média, menos de 10 segundos para um vendedor típico, no aparelho Android do próprio cliente e em rede móvel. As seguintes são bem mais rápidas, porque só trazem o que mudou.
O que muda dentro do aplicativo#
Dentro do aplicativo, offline-first impõe três mudanças estruturais, e nenhuma é visual: a tela passa a ler do banco local em vez de chamar a API, a escrita vira duas etapas — grava no aparelho e entra numa fila —, e o registro nasce com identidade própria, gerada no dispositivo antes de qualquer contato com o servidor.
Três mudanças estruturais, e nenhuma é visual.
A tela passa a ler do banco local. A lista não chama a API: a interface observa o banco do aparelho e se atualiza sozinha quando ele muda — porque o usuário criou algo ou porque a sincronização trouxe novidade. É o que faz a busca sobre milhares de registros ser instantânea, com ou sem rede.
A escrita vira duas etapas. O registro é gravado no banco local e enfileirado; a fila sobe quando há rede. Para o usuário, o cadastro terminou no instante em que ele salvou.
O registro nasce com identidade própria, gerada no aparelho antes de qualquer contato com o servidor. Sem isso, nada criado offline poderia ser referenciado por outro registro até o app conseguir perguntar "que número você deu para isso?".
Há uma decisão nossa com consequência direta no escopo. Usamos o RxDB como camada de dados reativa, e o armazenamento persistente oficial dele para SQLite é um plugin comercial — parte das licenças Premium, com versão de avaliação limitada a 500 documentos e sem índices, o que não serve para uma base de milhares de registros. Nossa saída foi rodar o RxDB em memória e manter, por conta própria, um espelho em SQLite no aparelho.
A consequência disso é a parte que interessa a quem contrata: a base sincronizada ocupa memória do aparelho. Decidir o que desce para o dispositivo deixa de ser só uma questão de tempo de download e vira orçamento de memória. É o que torna a próxima seção obrigatória em vez de recomendável.
O que muda no servidor#
A maior parte do trabalho de offline-first não está no aplicativo, está no servidor. A API deixa de responder "me dê a lista de clientes" e passa a responder "o que mudou desde a última vez que conversamos". Disso decorrem três exigências: exclusão vira marcação, a ordem entre entidades importa, e o envio acontece antes do recebimento.
Esta é a parte que costuma surpreender: a maior parte do trabalho de offline-first não está no aplicativo.
Uma API tradicional responde "me dê a lista de clientes". Um aplicativo offline pergunta outra coisa: "o que mudou desde a última vez que conversamos?" — e o servidor precisa entregar criações, alterações e exclusões desde um ponto de referência que o próprio app guarda.
Disso decorrem três exigências:
- Exclusão passa a ser marcação, não remoção. Se o registro simplesmente sumir do banco, ele não aparece na lista de mudanças e o aplicativo nunca fica sabendo que precisa tirá-lo da tela do usuário.
- A ordem importa. Registros que dependem de outros precisam subir e descer na sequência certa — a região antes do cliente, o cliente antes da visita.
- Envio antes de recebimento. O aplicativo primeiro manda o que está na fila e só depois pergunta o que há de novo — na ordem inversa, a versão antiga do servidor volta por cima de uma alteração que ainda não subiu.
E há o recorte por permissão, que é a otimização mais subestimada do assunto. Na Reticar, o vendedor só recebe no aparelho o que ele tem direito de ver: as visitas em que é o responsável e os clientes das regiões a que está vinculado. A base tem milhares de clientes; o que desce para cada celular é uma fração disso — o que melhora download, consumo de memória e segurança ao mesmo tempo, porque dado que não desce não vaza se o aparelho for perdido.
E o esforço merece ser dimensionado com honestidade: instrumentar cada entidade para participar da sincronização é trabalho manual. No projeto da Reticar, esse módulo do servidor passa de 1.300 linhas. Não é uma chave que se liga.
O que não vai para o aparelho#
O que mais economiza dinheiro num projeto offline é decidir o que não desce para o aparelho, e é decisão de produto, não de engenharia. O critério não é a importância do dado: é se ele tem fim. Catálogo e dado operacional do usuário descem; histórico ilimitado, dado de tempo real e dado que não é do usuário ficam no servidor.
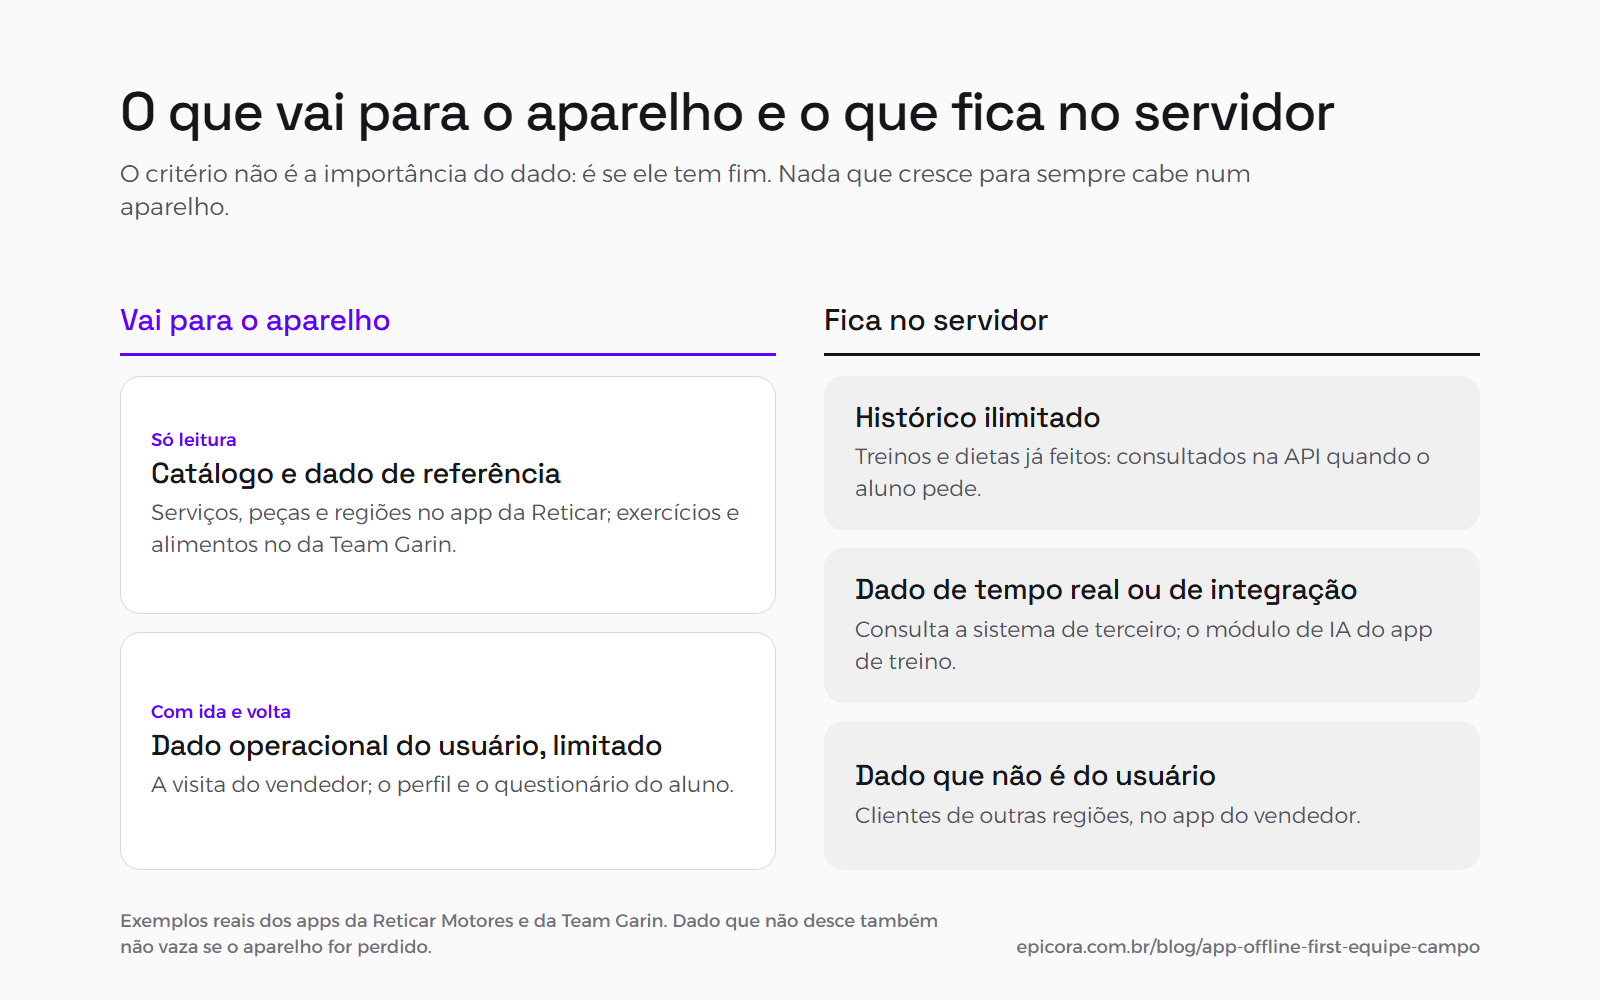
Esta é a decisão que mais economiza dinheiro num projeto offline, e é de produto, não de engenharia. O critério não é a importância do dado — é se ele tem fim.
| Tipo de dado | Vai para o aparelho? | Exemplo real |
|---|---|---|
| Catálogo e dado de referência | Sim, só leitura | serviços, peças e regiões no app da Reticar; exercícios e alimentos no app da Team Garin |
| Dado operacional do usuário, limitado | Sim, com ida e volta | a visita do vendedor; o perfil e o questionário do aluno |
| Histórico ilimitado | Não | treinos e dietas já realizados: a conclusão é enfileirada e enviada, mas o histórico é consultado na API quando o aluno pede |
| Dado que exige tempo real ou integração | Não | consulta a sistema de terceiro, e o módulo de inteligência artificial do app de treino |
| Dado que não é do usuário | Não desce | clientes de outras regiões, no app do vendedor |
A linha do histórico é a que gera mais discussão em reunião de escopo, e é a mais fácil de defender: histórico cresce para sempre, e nada que cresce para sempre cabe num aparelho. Foi assim que definimos o escopo offline do aplicativo da consultoria esportiva Team Garin, hoje virando um produto SaaS: o aluno precisa registrar o treino de hoje sem sinal — ele não precisa carregar dois anos de treinos no bolso para isso.
O mesmo raciocínio, aplicado a volume, resolveu o app de campo do sistema de gestão genética da DGA Intelligence: o rebanho é grande demais para descer inteiro, então o aplicativo sincroniza apenas os animais com situação ativa, e o que sai desse conjunto é removido do aparelho na sincronização seguinte.
Também há o caso em que o offline precisa cobrir a operação inteira porque ela acontece, de fato, sem sinal: é o que fazemos no app de gestão de ativos e hardware da GT, cuja operação visitamos em campo para remodelar o aplicativo — o registro dessa visita está no YouTube.
Conflito, e o que acontece com a escrita que o servidor recusa#
Quando duas pessoas editam o mesmo registro sem sinal, o padrão mais comum é a última alteração que chega ao servidor prevalecer, sem mesclagem e sem aviso. O caso mais incômodo é outro: a escrita que o servidor recusa em definitivo trava a fila, e descartá-la deixa o registro marcado como não sincronizado no aparelho, para sempre.
Duas pessoas editam o mesmo registro sem sinal. Quando reconectam, o padrão mais comum — e o que usamos — é simples: a última alteração que chega ao servidor prevalece, sem mesclagem e sem aviso. Para cadastro e registro de campo, onde cada pessoa mexe no que é dela, basta. Para edição colaborativa do mesmo documento, não — e mesclar campo a campo custa bem mais, então a decisão pertence ao escopo.
Existe um segundo caso, menos discutido e mais incômodo: a escrita que o servidor recusa em definitivo. Um registro criado offline que fere uma regra de validação será rejeitado hoje, amanhã e sempre. Como a fila é ordenada, essa entrada trava tudo que está atrás dela.
A saída usual é descartar a entrada depois de um número de tentativas, para destravar o restante. Isso é razoável, e tem um efeito colateral que precisa ser dito em voz alta: o registro continua no aparelho marcado como não sincronizado, para sempre — sem explicação do motivo e sem caminho para resolver. No app da Reticar, cada ordem de serviço carrega esse estado num ícone próprio, sincronizada ou não; o que o ícone não conta é se ainda há esperança.
Não existe resposta única — existe decisão consciente. Avisar o usuário, mandar o registro para uma área de quarentena ou aceitar a perda são caminhos com custos diferentes; o erro é não escolher. Offline-first garante que a equipe consegue trabalhar sem sinal; não garante sozinho que tudo que foi digitado chegou.
Que escrita o servidor recusa na prática, e por que a validação vai para o app#
Na prática, quase toda escrita recusada nasce de uma regra que o servidor conhece e o aplicativo não: um limite de tamanho, um cadastro desativado, um campo que virou obrigatório. No app de checklist da GT, a versão 1.0.5 deixou quatro casos assim à mostra, e a decisão foi validar no próprio aplicativo tudo o que ele tem como saber.
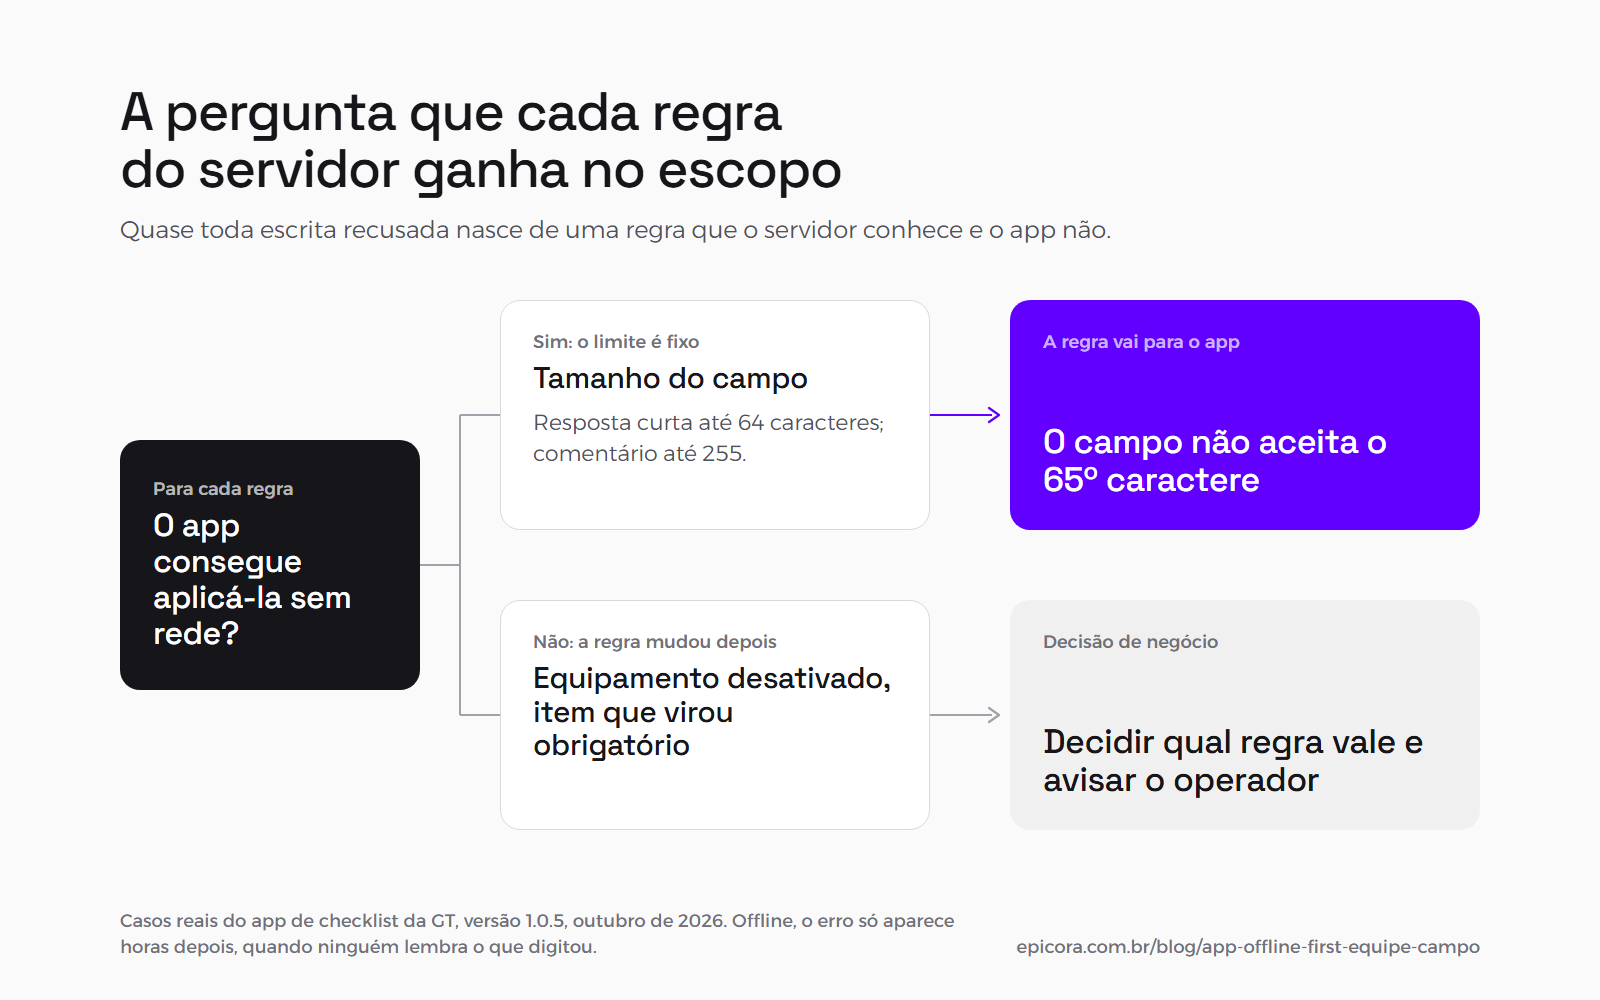
A GT vende software de gestão de manutenção para empresas com frota, e o operador preenche no aplicativo o checklist de cada equipamento, muitas vezes sem sinal. A versão 1.0.5 do app, com a correção da sincronização, passou pelo nosso teste de qualidade em 21 de outubro de 2026 e chegou às lojas no dia seguinte. Mesmo com ela, quatro situações ainda faziam o servidor recusar o registro feito offline:
| Caso real | Por que o servidor recusa | O app tinha como saber? | Saída |
|---|---|---|---|
| Resposta curta com mais de 64 caracteres | o campo aceita no máximo 64 | sim, o limite é fixo | limitar o campo no próprio app |
| Comentário com mais de 255 caracteres | o comentário aceita no máximo 255 | sim, o limite é fixo | limitar o campo no próprio app |
| Equipamento desativado enquanto o app estava offline | quando o registro chega, o equipamento já não está ativo | não: a desativação aconteceu depois que o aparelho perdeu o sinal | decidir qual regra vale e avisar o operador |
| Item deixado em branco que passou a ser obrigatório | a regra mudou no servidor depois do preenchimento | não: o app preencheu com a regra antiga | decidir qual regra vale e avisar o operador |
Os dois primeiros são os mais baratos de evitar. O limite existia no banco do servidor e não existia na tela. Online, o erro volta na hora e a pessoa corrige; offline, o operador termina o checklist, guarda o celular e o erro só aparece horas depois, quando ninguém lembra mais o que digitou. Por isso a regra vai para o aplicativo: o campo não aceita o 65º caractere. Toda validação do servidor que não depende de dado que muda (tamanho, formato, campo obrigatório desde sempre) precisa existir também no app.
Os dois últimos não se resolvem no aparelho, porque a regra mudou depois que ele ficou sem rede. A pergunta é de negócio: vale a regra do momento em que o operador preencheu ou a do momento em que o registro chegou? Para registro de campo, a do preenchimento costuma ser a mais defensável, porque o operador fez o que o sistema pedia quando estava diante do equipamento. Qualquer que seja a resposta, ela precisa estar decidida antes de alguém desativar um equipamento com checklists na fila.
O método que fica para qualquer projeto offline: cada regra de validação do servidor ganha uma pergunta no escopo, o app consegue aplicá-la sem rede? Se consegue, ela vai para o app. Se não consegue, alguém decide o que acontece com o registro que chega fora da regra.
Perguntas frequentes#
Offline-first é a mesma coisa que cache ou PWA?#
Não. Cache guarda a resposta de uma requisição que já aconteceu e serve para acelerar leitura. Offline-first é o aplicativo ter um banco de dados próprio no aparelho como fonte do que aparece na tela, incluindo o que o usuário cria sem sinal. O teste prático: em modo avião, um app com cache mostra o que já foi visto; um app offline-first deixa cadastrar algo novo, e esse registro sobrevive a fechar e reabrir o aplicativo.
Meu aplicativo já tem modo offline. Isso basta?#
Depende de como ele se comporta em conexão ruim, que é diferente de conexão ausente. Muitos apps com modo offline sincronizam tudo na abertura e bloqueiam a interface enquanto isso acontece — em rede lenta, o resultado é pior do que não ter offline. Os sinais de que não basta são: o app trava ao abrir, demora sem explicar o que está fazendo, ou não deixa claro se o que foi registrado já subiu.
Dá para adicionar offline depois que o aplicativo já está pronto?#
Dá, mas não é um ajuste no aplicativo: é uma mudança no servidor também. A API precisa passar a responder "o que mudou desde tal ponto", aceitar registros com identificador gerado pelo próprio aparelho e marcar exclusões em vez de apagar de fato. Por isso a conversa de offline começa pela equipe de backend, não pela de mobile.
Preciso de offline se minha equipe trabalha só em área urbana?#
Provavelmente não pelo motivo que você imagina, mas talvez sim por outro. O critério não é a cidade, é onde o trabalho acontece: subsolo, galpão, elevador, estacionamento e prédio industrial derrubam sinal dentro de capital. Se a pessoa usa o sistema sentada, com Wi-Fi, offline-first é custo sem retorno.
O que acontece se duas pessoas editarem o mesmo registro offline?#
No padrão mais comum, a última alteração que chega ao servidor prevalece, sem aviso e sem mesclagem. Isso é aceitável para cadastro e registro de campo, onde cada pessoa mexe no que é seu, e é insuficiente para edição colaborativa do mesmo documento. Vale decidir isso no escopo, porque a alternativa — mesclar alteração campo a campo — custa consideravelmente mais.
Fontes#
- Ink & Switch — "Local-first software: you own your data, in spite of the cloud" (2019), de Martin Kleppmann e coautores — https://www.inkandswitch.com/essay/local-first/
- RxDB — SQLite RxStorage (documentação oficial do armazenamento em SQLite) — https://rxdb.info/rx-storage-sqlite.html
- RxDB — licenças Premium (quais plugins são comerciais e os limites da versão de avaliação) — https://rxdb.info/premium/
Próximo passo#
Se a sua equipe trabalha onde o sinal falha, o ponto de partida não é escolher tecnologia: é decidir o que precisa funcionar sem rede e o que não vai para o aparelho. Foi assim que substituímos o sistema comercial de campo da Reticar Motores — e é o tipo de decisão que tratamos em sistema sob medida.
Quer olhar isso no seu caso?
Conte em poucas linhas o que você tem hoje. A gente responde com o caminho que faz sentido, inclusive quando a resposta é não construir nada.